
上下文的威力是无与伦比的强大的,下面这篇文章基本上AI基于我做这件事情的上下文和我的个人画像写出来的。当我下午五点多开会得知Moss能识别的这么好的时候,真就是迫不及待的就用在自己的产品上了。
10月9日晚上 19:36,我把 MOSS-Transcribe-Diarize 的链接丢给 Claude Code,问了两个问题:这个能不能用?比我现在的人声分离好不好?21:12 拿到结论:在我自己的三段录音上,它在速度、分人、文字、专名四项上都比原来强,值得换。当晚定下主转写换成它,第二天在它上面做好了声纹认人,10月11日合进碎碎念。
模型是别人做的,我能做的是比对和决定。比对能一个晚上做完,靠的是这一年半攒下的东西:原始录音一条没删,转写稿我自己改过,专名有一份从我的语料里长出来的词典,说话人我愿意花时间标。下面按顺序写:为什么要分出谁说的、原来的做法差在哪、为什么能比得这么快、比出来的数、怎么接进来。
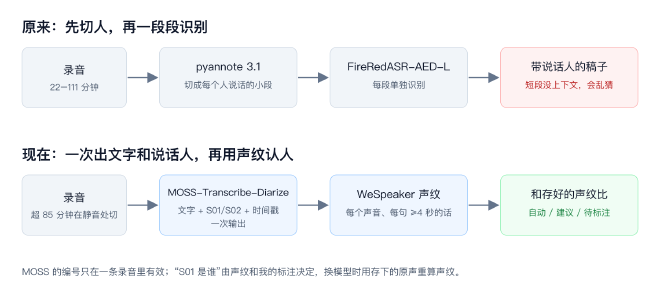
为什么一定要知道是谁说的#
碎碎念记我每天的录音、截图、随手记,再从里面学关于我和我身边的人、事、项目的记忆。它的记忆层定过一条规矩:录音转写稿只学项目,不学人。原因是稿子里没有说话人,一句「这个我来跟」,分不清是我说的还是别人说的,学进去就会把别人的话记到我头上,导致AI做的会议纪要待办压根没法看。
能分出谁说的以后,录音里的四件事才用得上:
- 精准知道是谁说的。 转写稿按人分段,段首是名字和时间;纪要可以按人名写。
- 回头追溯。 搜一句话,看到是谁在第几分几秒说的,点开就是原声。几周后再争论「当时是谁定的」,不用靠记忆。
- 按人分任务。 会上谁说了「我来跟」,任务就归谁,不再是一句不知道归属的「待办」。
- 识别观点。 同一个问题谁支持、谁反对,各自的理由是什么。我自己说过的观点,记忆层终于可以学。
所以这次要的不只是「转得更准」,是「每句话都知道是谁的」。
原来的做法差在哪#
服务跑在我的 Mac Studio(M3 Ultra,96 GB)上,用 GPU(MPS)推理。两个模型:FireRedASR 的 AED-L(1.1B 参数,中文强)负责转写,pyannote 的 speaker-diarization-3.1 负责分人。对外有两个接口,问题各不相同。
正式在用的接口:不分人,靠事后纠正#
碎碎念平时调的是不分人的接口,每天的转写稿都出自这里。
- 没有说话人。 上一节说的四件事,一件都做不了。
- 30 秒一块,块和块之间没有上下文。 FireRedASR 的编码器用自注意力,占的内存随音频长度的平方涨,35 分钟的录音一次过要 205 GiB。服务只能按静音切成 30 秒一块,逐块识别。一句话被切在两块之间,前后就接不上。
- 没有标点。 稿子是一长串字。
- 专名只能事后改。 FireRedASR 没有热词或上下文提示的入口,人名、产品名、型号写错了,只能靠出稿后的专名纠正:规则替换、按读音找近音词、本机 Ollama 上的 qwen3:30b-a3b-instruct-2507 看上下文改,还有一层用 FireRedASR 的候选结果做声学证据。最后这层实测一次都没命中过。
- 纠正本身会误改。 词典每加一个词,就可能多一种误改。这次把「MOSS」加进词典的当天,普通词「模式」就开始被改成 MOSS。
分人的接口:先切人,再一段段猜#
分人的接口一直在,碎碎念没用它,日志里一共只有 16 次调用,看起来都是测试。它的做法是先让 pyannote 切出每个人说话的段落,再把每段单独送去识别。问题出在切:
- 段一短,模型就猜。 没有上下文,FireRedASR 会把字认成读音相近的别的词,还会凭空编出整句话。
- 短于 0.2 秒的段直接丢掉。 「嗯」「对」这种插话没了。
- 两人同时说话,重叠部分只算给一个人。
- pyannote 会并人、拆人。 一问一答的两个人被并成一个人,一句话被拆给两个人。
- 慢。 22、31、111 分钟的三段录音,分别要 282、352、1461 秒。
同一段录音、同一时间点,三种做法写出来的字(「正式稿」是我改过的正式转写稿):
| 时间 | 分人接口 | 正式稿 | MOSS |
|---|---|---|---|
| 10:13 | 公寓吗 | 功率吗 | 功率吗? |
| 20:02 | 看电视 | 好牛逼看电视 | 我看电机。 |
| 20:09 | 年级那个表格 | 那个那个表格 | 电机那个表格 |
| 20:32 | 是人才经济学知道吗 | 是离开经济区你知道吗 | 是原来电机选的尺寸吗? |
| 10:48 | 很久没工作了今天想让你看看我的老婆 | (没有这句) | (没有这句) |
最后一行是分人接口凭空编的,录音里没人说过。
为什么一个晚上就能比完#
评估一个转写模型,难的不是跑模型,是知道它对不对:要有标准答案,要有一把能量「专名写对几处」的尺子,要知道每个声音是谁。这些我手上都有,不用临时去做:
- 原始录音一条没删。 碎碎念里存着 54 条录音,37.4 小时,最早一条是 2025年5月7日。挑哪三条比,同一份音频让两套系统各跑一遍,随时可以。
- 转写稿我改过。 正式稿出来以后,听错的人名、产品名我会手改。这三段改过的稿子就是参考稿,用来数专名在录音里出现了几次。
- 专名词典是自己长出来的。 504 个专名,其中 57 个有记录在案的听错写法,一共 134 种。词典有三个来源:一份种子勘误表、从我自己的文档里抽出来的词、我改稿时回流的错法。它在这次评估里当了两回事:挑 55 个有听错记录的专名直接当热词喂给 MOSS;再拿它当尺子,数每套系统写对了几处。
- 纠正日志保留原稿。 每次转写,纠正前的原文和改了哪些都记一份,不覆盖。哪些错是模型的、哪些是纠正程序改出来的,分得开。
- 说话人我自己标。 第一轮比完,Claude 给三段录音里的 16 个声音做了一个标注网页,每个声音放几段原声。我第二天早上听一遍、填上名字,把结果贴回去,认人的门槛就是拿这份标注定的。
没有这些,第一步就得先人工逐字听写一段当标准答案、再把说话人一个个标出来,那是几天的活,而且只能比一次。现在这些数据就在那儿,每出一个新模型都能拿同一套再比一遍。
这次的时间线:
| 时间 | 发生了什么 |
|---|---|
| 10月9日 19:36 | 提问 |
| 19:39 | 第一轮判断:我的正式稿没有说话人,要比的是「从没有到有」,以及和闲置的分人接口比 |
| 19:55 | 让它跑三段录音 |
| 21:12 | 出结论 |
| 21:48 | 出声纹认人的接入方案 |
| 22:05 | 我拍板:主转写换 MOSS,记录录音里其他人的声纹 |
| 23:36 | 转写服务的新接口跑通 |
| 10月10日 09:36 | 我把 16 个声音的标注贴回去 |
| 09:45 | 认人门槛定了 |
| 13:18 | 标注写进碎碎念,App 里能看到说话人 |
| 10月11日 13:07 | 合进碎碎念主分支 |
MOSS-Transcribe-Diarize 是什么#
- 模思智能(OpenMOSS)2026年7月9日开源,Apache-2.0 协议。
- 0.9B 参数:Whisper-Medium 的音频编码器,接一个 Qwen3-0.6B 结构的解码器,支持 50 多种语言。
- 一次输出文字、说话人编号和时间戳,格式是
[开始秒][S01]说的话[结束秒],带标点。 - 提示词里能带热词,写成
热词提示:A, B, C。 - 官方只给了 CUDA 的跑法。我用的是社区转好的 MLX 8-bit 版,1.3 GB,mlx-audio 0.5.8 已经内置了这个模型。
- 上下文 128k。音频每秒占 12.5 个 token,再给输出留出位置,一次大约能放 90 分钟。这是按上下文估的,官方没写上限。
官方自己报的成绩里,会议数据集 AISHELL-4 的 cpCER(字错和说话人归错一起算)是 15.83,纯字错率 14.84,两者只差 1 左右,说明它很少把话归错人。但官方的对比表里既没有 pyannote 这种先切人再识别的做法,也没有 FireRedASR,跟我原来那套差多少,只能自己比。
比出来的数#
三段多人讨论的录音:22、31、111 分钟,每段 4 到 6 个人说话。111 分钟那段超过一次的上限,在 54 分钟处的静音切成两段。每段跑三遍:原来的分人接口(关掉专名纠正)、MOSS、MOSS 加热词。没有逐字的标准答案,只比数得清的东西,文字准不准靠抽查。
速度#
| 22 分钟 | 31 分钟 | 111 分钟 | |
|---|---|---|---|
| 分人接口 | 282 秒 | 352 秒 | 1461 秒 |
| MOSS | 64 秒 | 125 秒 | 656 秒 |
| MOSS + 热词 | 65 秒 | 126 秒 | 660 秒 |
| MOSS 每秒生成的 token | 141 | 113 | 73–78 |
MOSS 快 2.2 到 4.4 倍。带热词多花 1 到 4 秒。录音越长,每秒生成的 token 越少:111 分钟那段的前后两半,分别生成了 1.8 万和 2.9 万个 token。
分人#
| 22 分钟 | 31 分钟 | 111 分钟 | |
|---|---|---|---|
| 分人接口分出几个人 | 5 | 5 | 9 |
| MOSS 分出几个人 | 5 | 4 | 9(两段相加,同一个人被算了两次) |
抽查 31 分钟那段:pyannote 把一问一答的两个人并成了一个人,又把一句话拆给了两个人;这些地方 MOSS 都分对了。整段看,pyannote 把 68% 的说话时间归给了同一个人,MOSS 分出来说得最多的人占 52%。
MOSS 也没有漏段:pyannote 判定有人说话的地方,没有哪一段被 MOSS 漏掉 6 秒以上。
文字#
上面那张逐句对照表就是抽查的结果:MOSS 比我改过的正式稿还准,带标点;分人接口最差。这条没有标准答案撑着,只算抽查。
专名#
以我改过的正式稿为参照,31 分钟那段里专名出现 23 次,111 分钟那段 101 次。各套写对了几处:
| 31 分钟(23 处) | 111 分钟(101 处) | |
|---|---|---|
| 分人接口(不纠正) | 2 | 27 |
| MOSS | 0 | 66 |
| MOSS + 专名纠正 | 17 | 98 |
| MOSS + 热词 | 6 | 97 |
| MOSS + 热词 + 专名纠正 | 20 | 100 |
- 31 分钟那段型号和厂商名多,MOSS 自己一处没写对。热词能救回一部分,比如「俯仰」不带热词时写成「抚养」,带热词后写出了 6 处(正式稿里只认出 2 处);两个厂商名和一个芯片型号带了热词也没改过来,要靠后面的纠正。
- 111 分钟那段带热词时,MOSS 还多写出了 57 处专名,正式稿里没有。抽查下来多数是正式稿自己漏了:比如 Pogo Pin(一种弹簧针连接器),正式稿写的是「霍克片」「破口病」。
- 热词有副作用。55 个全塞进去以后,一段讨论电路的录音里,「MOS 管」的 MOS 被改成了 MOSS。热词要按录音的领域挑,不能一份全量。
- 专名纠正换到 MOSS 后面照样能用。纠正有四层:规则、读音、本地大模型、FireRedASR 的候选结果。前三层只看文字,跟哪个模型转写的无关;第四层换了模型就用不上,但它本来就没命中过。
它的短处#
- 一次放不下的长录音切段以后,同一个人前后两段的编号对不上:前段叫 S01,后段可能叫 S02。
- 它也会并人、拆人,这是标注以后才看出来的:111 分钟那段的 S01 里混进了我的一段话;22 分钟那段有一个编号是两个人;还有一个人被拆成了两个编号。
决定:主转写换 MOSS,认人另起一层#
10月9日晚上我定了:碎碎念的主转写换成 MOSS。原来不分人的接口留着,给别的调用方用;新接口失败时,App 退回老接口。
MOSS 只管一条录音里有几个声音、各自说了什么。S01 只在这一条录音里有效,它不知道 S01 是谁。要认出是谁,得自己加一层声纹。我提的要求是:系统把录音里的声音列出来,我来标这是谁;标过的人,声纹跟着这个人的记忆走,App 以后一直认得他;哪怕将来换了模型,顶多重新算一次声纹。落成四条规定:
- 分人、声纹、认人三层分开。 换掉任何一层,另外两层不动。
- 存原声,不只存向量。 每个人的声纹是 vault 里的几段原声片段,算出来的向量只当缓存,按声纹模型分开存。换模型就用原声在后台重算,不用我重标。
- 转写稿里只写 S01、S02,「S01 是谁」另存一层。 改名、合并人物、改标注都不用重写转写稿。
- 只有我确认过的标注才往声纹里加样本。 自动认出的、给建议的都不加,免得认错一次以后越认越偏。
声纹只留在本机和我自己的 iCloud 里,不进任何大模型的提示词。
接进来以后#
转写服务#
新加一个 /v2/transcribe 接口:
- MOSS 一次出文字、编号和时间戳;
- 用 WeSpeaker ResNet34(pyannote 自带的那个)给每个声音算一个平均声纹;
- 超过 85 分钟就在静音处切段,按声纹把前后段的编号对上;
- 4 秒以上、不跟别人重叠的句子,每句单独带一个声纹;
- 最后照常过专名纠正,热词按录音的领域挑。
三段录音走一遍新接口,分别用了 87、156、797 秒,原来的接口输出跟改动前逐字一致。
声纹分得开吗#
先看 WeSpeaker 能不能把人分开:同一个人在三段录音里的声纹,两两相似度 0.85 到 0.88;不同的人大多低于 0.5,最高 0.63。按这个定了认人的门槛:
| 档 | 门槛 | 依据 |
|---|---|---|
| 自动认出 | 相似度 ≥ 0.70,并且比第二像的人高出 0.10 | 不同人之间最高 0.63 |
| 给建议,等我确认 | ≥ 0.55 | 同一个人的分数一次都没低于它 |
| 未标注 | 更低 |
一段样本够不够#
我问过:每个人存一段声音不够吗?拿标注试了:跨录音能检验的认人有 6 次,每人只给 1 段样本,6 次第一名全部认对,但有 1 次分数只有 0.65,到不了自动线,只能给建议;每条录音各加 1 段样本后,6 次全部 ≥ 0.73。定下来的做法:第一次标注只存 1 段,之后每确认一条新录音加 1 段,最多 5 段。同一个人在会议室、手机外放、走廊里录出来的声音不一样,样本要来自不同的录音才有用。
端到端试了一遍:只在 22 分钟那段里标出「我」,另外两段里的我就被自动认了出来,分数 0.84 和 0.82。
被并错的人怎么办:逐句复核#
并人是最危险的错。111 分钟那段的 S01 主体是另一位同事,但混进了我的一段话;要是整个 S01 标成他,我那段话就会记到他头上。
它还会带偏声纹:S01 的平均声纹跟我的相似度到了 0.697,离自动认出只差 0.003。现在算平均声纹前先剔掉跟主体不像的句子,降到 0.604。
再加一层逐句复核:4 秒以上、不跟别人重叠的句子各有一份声纹,逐句跟已知的人比。用我的标注试,S01 里有 9 句被改了归属,8 句改给我,集中在第 60 到 65 分钟,1 句改给另一个人;三个干净的声音一句都没被误改。
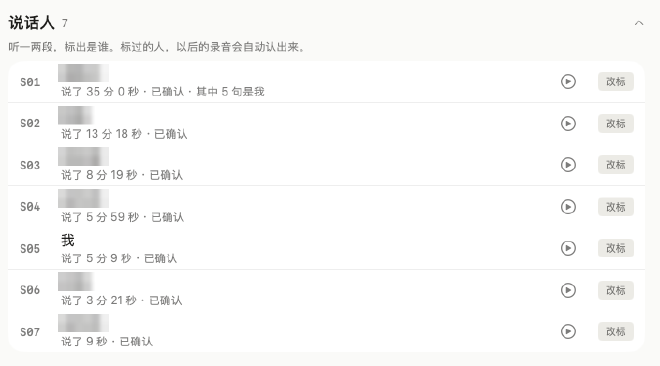
下面是这段录音标完后的样子(同事的名字打了码)。S01 后面写着「其中 5 句是我」:1 句是我手标的,另外 4 句是逐句复核从别人名下找回来的;S04 和 S07 是同一个人,MOSS 把他拆成了两个编号,标注时归到一起:
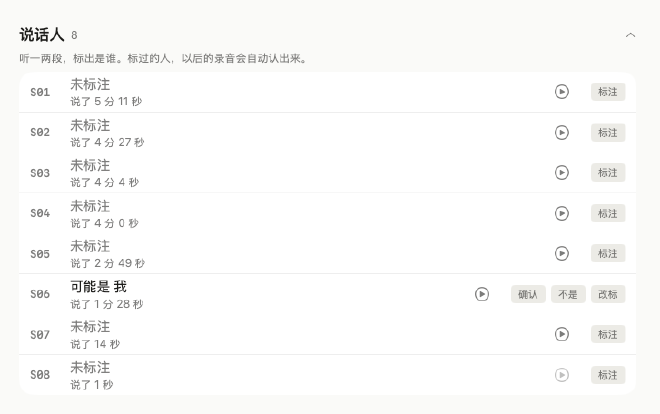
一条新录音进来时是这样:8 个声音,系统认出 S06 可能是我,等我点确认;其余 7 个还没认出来,等我听一两段再标。标过一次,以后的录音就自动认:
App 里现在能做的#
- 录音详情里「说话人」一节:每个声音一行,能试听,能标注、确认、改标、说「不是」。
- 「转译内容」只显示按人分的版本:同一个人连着说的归一段,段首是名字和开始时间,单句能改归属,顶部能搜索。
- 录音的「人物」跟着说话人标注走。
- 人物页有「声纹」一节,能试听、删样本;合并人物时声纹跟着并,删人时声纹一起删。
还没做的是纪要按人名重写,和让记忆层从我本人说的话里学东西。
踩过的坑#
- Hugging Face 的 xet 下载会卡住。 设
HF_HUB_DISABLE_XET=1走普通 HTTP。 - mlx-audio 少一个依赖。 要自己补装 jinja2。装进服务原有的环境时用
--no-deps,免得它升级服务已经在用的包。 - mlx-audio 的
hotwords=参数会把默认指令整个换掉。 不传提示词、只传热词时,模型收到的只有一串热词,没有「按说话人分段、带时间戳」那段指令。要自己拼完整的提示词,热词接在后面。 - 词典学会「MOSS」以后开始误改。 纠正程序把普通词「模式」改成 MOSS,把「模思智能」改成
MOSS智能。原因是按读音找近音词时,近音词没有跟原词一样受上下文条件约束。修法是近音词也要过上下文条件,原文里已经写对的专名不再改。 - 给整段音频算声纹会报错。 结束时间的浮点误差会超出音频长度,App 建声纹时每次都撞上;现在留了 1 毫秒余量。
- 标注一度没写进真实数据。 第一轮标注只拿去定了门槛、跑了临时副本,App 里看到的还是「未标注」,我问了才补写进去。
几点体会#
- 选型的速度取决于手里有没有自己的评测集。 官方榜单用的是公开数据集,我的录音是我自己的口音、我自己的专名、我身边的人。三段自己的录音、一份自己的词典、一份自己的标注,一个晚上就能比完;下一次出新模型,同一套数据再跑一遍。
- 原始数据别删。 录音、改过的稿子、纠正前的原文,平时看着占地方,评估的时候它们就是标准答案。
- 标注是一次性投入。 16 个声音听一遍,门槛就定了;以后每标一个人,后面所有录音都受益。
- 一次出文字和说话人,比先切再识别好在上下文。 原来分人接口的乱猜和编句,都出在被切短的段落上。
- 模型会错,就留一层我能改的。 MOSS 会并人、拆人,我用声纹、一次人工标注和逐句复核兜底。以后出了更好的分人模型,换上去,重算一遍声纹就行。
大家有什么好用的模型Mac Studio上跑的模型可以分享给我一下,或者说对我这个方案有什么更好的建议可以指正。