
如果有人问我,我花时间,花 Token 来做这么一个没有用的东西有价值吗?我的回答是肯定的,最大的意义其实就在于,证明 Vibe Coding 在硬件领域正在快速成长,为什么呢?因为数字世界已经到了一定的瓶颈了,是需要物理世界来反哺数字世界。如果没有 AI Agent 发展到今天这个程度,我是完全不敢想象自己要能做这件事要花多少时间去学习硬件、嵌入式、软件、通信等知识,要去查多少资料,这都需要时间的积累,但这些积累在数字世界基本都有了,硬件的东西像乐鑫这样子专业的公司做了就行了。
事情是这么开始的。
乐鑫 8月19日 发的 ESP-Mosaico 是一块专门给 Coding Agent 用的模块化开发板。其实我知道它很粗糙,看到用户反馈说还是 3D 打印的部件,但我还是想看看现在 AI 硬件领域生态做的最好的 ESP32 系列到底是怎么做的,尤其是它现在的 Vibe Code 模式。它的上手方式和以前的开发板不一样:不给你看引脚图,先给你一句提示词,让你丢给 AI 编程工具。那句话是这样的:
Download the code from this repository: https://github.com/esp-mosaico/esp-mosaico-vibe
Set up the environment and implement a Snake game.
第一个作品是贪吃蛇。我照做了,用 Claude Code 跑完这一句,板子上就能玩了。10月2日 Meta 开源了 Muse Gadgets 的设备 SDK,官方推荐的硬件也是 ESP32,于是接着往下做:当天这块板变成了一台 Muse 小设备,后面持续迭代了一下就能用中文对话、把回复念出来、按 Muse 的要求拍一张照片发回去、我走近的时候亮灯打招呼。
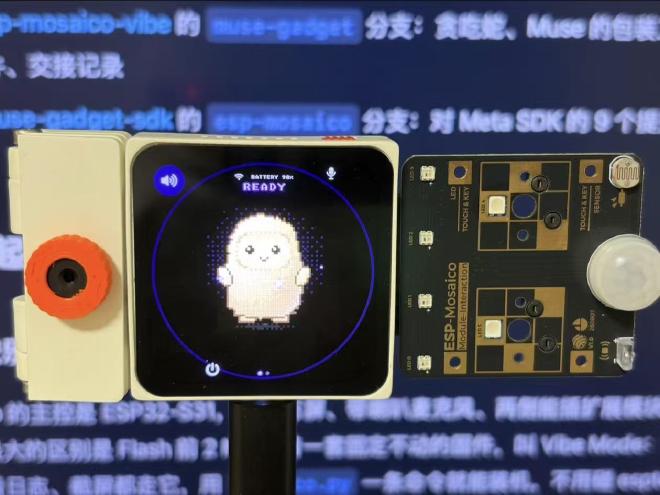
整个过程是我和 Claude Code 一起做的,前后开了四个会话,其中两个在同一块板子上并行干活。这篇按发生的顺序写,分五段,每段后面放一点做的时候顺手想到的,最后放大看。代码在这两个仓库:
- rowline/esp-mosaico-vibe 的
muse-gadget分支:贪吃蛇、Muse 的包装工程、蓝牙诊断固件、交接记录 - rowline/muse-gadget-sdk 的
esp-mosaico分支:对 Meta SDK 的 9 个提交
一、先玩起来#
第一步:按乐鑫的剧本做贪吃蛇#
ESP-Mosaico 的主控是 ESP32-S31,480 方屏、带喇叭麦克风、两侧能插扩展模块。它和普通开发板最大的区别是 Flash 前 2 MB 住着一套固定不动的固件,叫 Vibe Mode:装应用、恢复、看日志、截屏都走它,用 mosaico.py 一条命令就能装机,不用碰 esptool。开机按住橙色的 AI 键就进 Vibe Mode,所以应用写坏了也不会变砖。
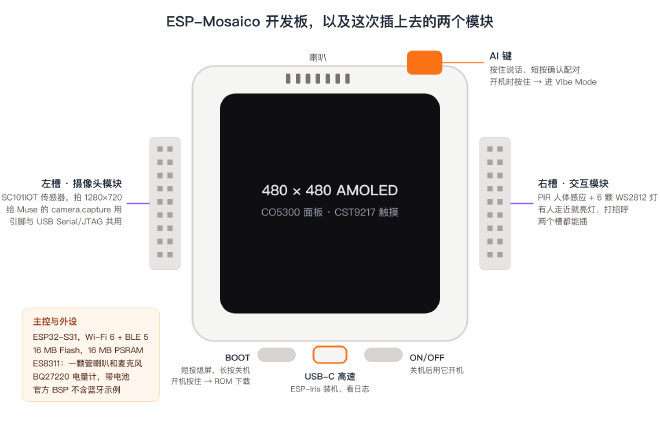
那句提示词丢进去之后,AI 先花了一个晚上搭环境,坑都在环境这一层,不在游戏:
- ESP-IDF 要钉到一个具体的提交。 工作区要求
master上的7b9cc1ac,不是最新版,装好后报的版本号是 6.2.0。 - 国内组件镜像缺版本。 从这个网络访问乐鑫的组件服务会被转到国内镜像,镜像上没有 esp-gsp 1.5.1。最后从官方 API 下载、核对哈希,搭了一个本地组件库。
- GSP 场景编译器官方没发。 组件要求的 0.6.1 不存在,用了工作区 CI 同款的签名版 0.5.0。
以上都是 Claude Code 自己执行完成的,我什么也没有做。游戏本身用 Raylib Lite 写,规则和画法分两个文件,同一份 C 代码在浏览器模拟器和板子上跑。20×18 的格子,吃一个苹果长一节、加一分,速度从每秒 6 格涨到 12.6 格,撞墙或撞自己结束,填满算赢。触屏上滑动转向,点一下开始或朝那边转,点分数栏暂停。8 个回放测试,每个场景存成回放再跑一遍,最终状态的哈希必须一致。
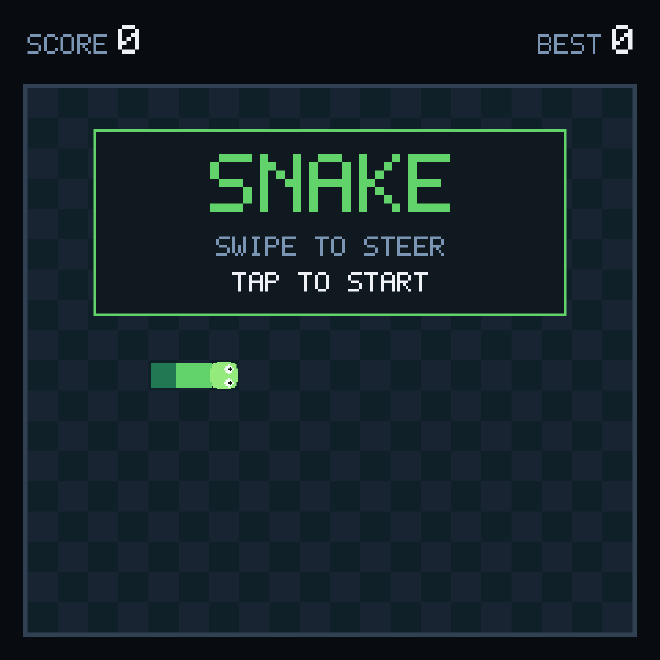
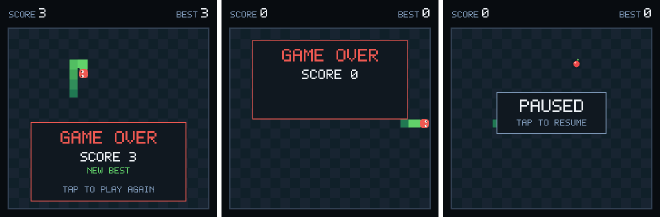
模拟器里顺手抓到一个模板的 bug:空白游戏模板只听触摸点 0,浏览器把鼠标报成点 1,所以点击没反应。改成跟着先按下的那根手指或鼠标走。
装上板子是第二天的事。板子第一次插上 Mac 认不到,换了根能传数据的线才出现。第一次用的板子先跑 recover 写 Vibe Mode 基础固件,再用 system-update 装贪吃蛇。装完核对三件事:设备 ID 不变、启动 ID 是新的、设备报告健康。板上实测 33.3 fps,没掉帧,触摸正常。
贪吃蛇做完,环境也就踩通了。接下来的 Muse 全部建立在这上面。
顺手想到:为什么又是 ESP32#
顺着这个看几个事情,自从 Anthropic 开源了 Claude Desktop Buddy、把自己的螃蟹装进 M5StickC 这块小板子里之后,多少人开始效仿,又有多少人去 Vibe Coding 自己的电子宠物,给个屏幕让它呈现出来,提供情绪价值,官方推荐的也是 ESP32 这个生态的东西,到这次 Muse 推荐的也是 ESP32 生态的,因为它足够简单,成长这么多年 AI 能在互联网上找到足够多的知识来帮助用户去实现他个人定制化的需求。
二、把板子变成 Muse#
Meta 开源了 Muse#
我买这块板子的时候预判到后面类似 GrokBot 这类产品肯定会接硬件设备的,方便我第一时间去玩,没想到 Muse 先干了,以开源项目的方式先干了。我之前也用手机模拟硬件设备接了 GrokBot。
Muse 是 Meta 做的个人 AI 助手。Muse Gadgets 开源的只有设备端:一套 ESP32 固件和一套树莓派用的 Linux SDK,Apache 2.0。助手本身不开源,设备要先去 gadgets.muse.ai 领一个 SDK token,再在 Muse App 里打开开发者模式配对。官方支持的板子里,带完整界面的是 Waveshare 1.75 寸圆屏 AMOLED 这一类。
初次使用,我发现 Muse 比 GrokBot 反应是要快很多的,应该是意图识别做的更好,GrokBot 说什么都要比较长的反应时间,GrokBot 本身没有做任何设备交互的工作,界面显示的内容和设备播报的内容不会完全一致,Muse 就好很多。
Vibe 价值就在于自由适配#
把 Muse 的固件直接编译给这块板,有三件事过不去:
- 开发工具版本对不上。 Muse 固件只认 ESP-IDF 6.0.1,而 6.0.1 不支持 ESP32-S31。这块板的工作区把 ESP-IDF 钉在 6.2 的一个提交上。
- 官方刷机方式会冲掉 Vibe Mode。 Muse 用
idf.py flash连引导程序、分区表一起写,前 2 MB 会被覆盖。 - 板子连不上 Meta 的服务器。
api.muse.ai和hatch.metaaivm.com在国内直连全部超时。
如果是我本人没有 Claude 的情况下,我都看不出来这三个问题,现在有了,不妨碍我继续玩下去。我的决定是:Vibe Mode 不动,把 Muse 做成一个标准的 ESP-Mosaico 应用,用 Vibe Mode 装机。后面的 Flash 的分法是 Claude 做的,变成下面这样。
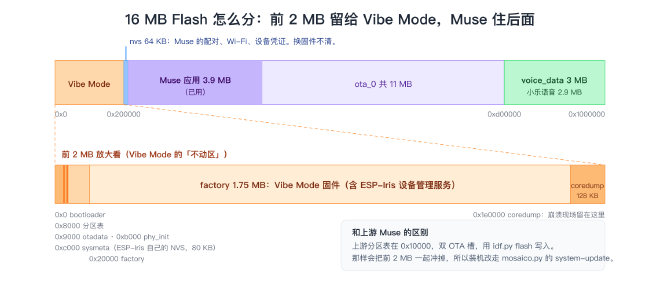
Muse 的配对信息、Wi-Fi 密码、设备凭证都在那块 64 KB 的 nvs 里,换固件不会清,所以后面十几次装机都没有重新配过对。这个点太重要了,如果不是做这个项目,我完全不知道还可以这样子操作。
代码分三层。Meta 的 SDK 只开了几个小口,板子相关的全部放在包装工程里,SDK 的 esp-mosaico 分支加起来 9 个提交,每一个默认都关着,其他板子的行为不变。
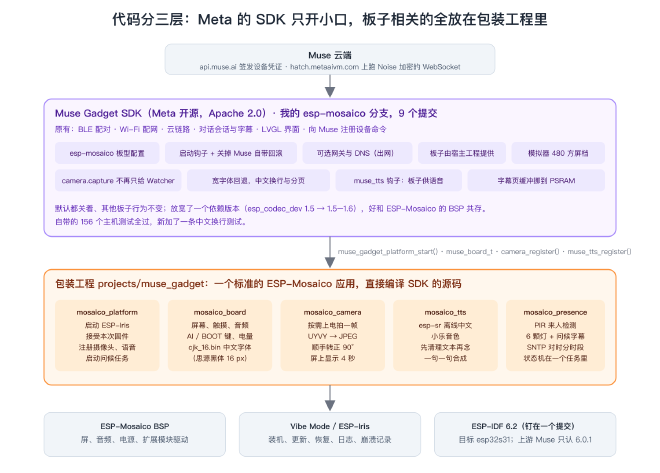
SDK 那边最早的两处改动是必须的:
- 启动钩子。 Muse 的
app_main在起 Wi-Fi、蓝牙和界面之前,调一个弱符号muse_gadget_platform_start()。包装工程给它一个强定义,在里面启动 ESP-Iris 设备管理服务、接受这次的固件。后来的摄像头、语音、问候也都从这里注册进去。 - 关掉 Muse 自带的回滚。 上游固件装好后 5 分钟内连不上 Muse 云端就自动回滚。这块板没配对之前肯定连不上,会被打回去。加了一个开关把它关掉,固件的验收交给 Vibe Mode。
先连上网#
板子不能像手机那样开个 VPN。路由器是普通家用的,改不了网关。最后的做法是把 Mac Studio 当旁路由,只让板子这一台走它,家里别的设备不动。
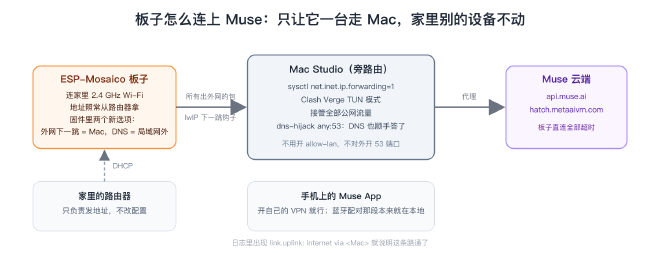
固件里加了两个配置项,默认为空:
- 外网下一跳。 板子照常从路由器拿地址、续约,只是发往外网的包交给指定的主机。用的是 lwIP 自带的转发钩子,DHCP 那一套完全不动。
- DNS。 网关生效时改用局域网外的 DNS。路由器续约会把 DNS 改回去,所以每 30 秒检查一次,被改回就重新设上。
Mac 这边本来以为要给 Clash 开局域网连接和 DNS 端口,查了才发现不用:它的 TUN 模式已经接管了全部公网流量,dns-hijack: any:53 会把经过它的 DNS 查询一并答掉。只需要打开 IP 转发:
sudo sysctl -w net.inet.ip.forwarding=1
这条重启会失效。手机上的 Muse App 开自己的 VPN 就行,蓝牙配对那段本来就在本地。
配对卡住的两个假故障#
无屏版 Muse 装上板子之后,日志里蓝牙一直在广播 MuseGadget-F46F0A,等人来配对。卡了一晚上,两个问题最后都证明和板子无关。
手机搜不到蓝牙。 iPhone 系统设置里的蓝牙列表只显示耳机、键盘这类设备,低功耗蓝牙的广播本来就不出现在那里。但 ESP-Mosaico 官方 BSP 的功能表里没有蓝牙,示例里一个用蓝牙的都没有,所以这块板的蓝牙到底能不能用,之前没人验证过。为了把 Muse 的因素排除掉,做了一个只做蓝牙收发的诊断固件 ble_diag:以 MosaicoBLE-DIAG 的名字广播,每 15 秒用板子自己的蓝牙扫 5 秒。结果每轮能听到 34 到 37 个设备,最强的信号 −37 dBm;手机装 nRF Connect 也看到了它。板子收发都正常。这个固件留在仓库里,以后怀疑蓝牙随时装上测一次。
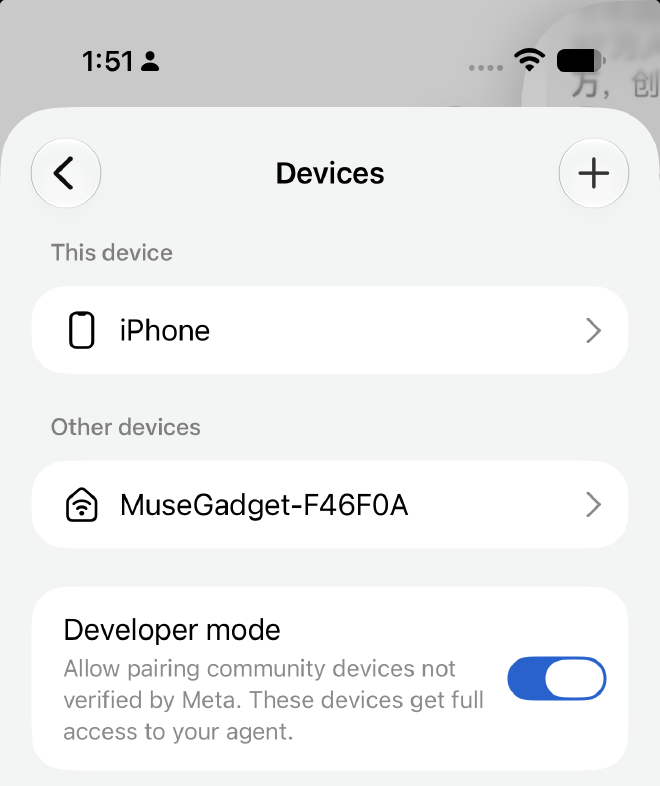
Muse App 开了开发者模式,没有添加设备的入口。 查了套餐、地区、iOS 测试版,都没有定论。第二天它自己出现了,是 App 那边的问题。下面是正常时候的样子,右上角的加号就是入口,开发者模式的说明写得很直白:允许配对没经 Meta 验证的社区设备,这些设备对你的助手有完整权限。
配对本身很顺:App 里选设备,日志提示确认时短按 AI 键,填 Wi-Fi 密码,板子重启后连上 Muse。
屏幕#
带屏幕的 Muse 界面是 LVGL 画的,上游用的板子是圆屏。移植有两个选择:照着 Muse 已支持的 Waveshare 板写一套驱动,或者用 ESP-Mosaico 官方的 BSP。选了 BSP:它认识这块板的两个硬件版本(引脚从 eFuse 读),管着屏幕依赖的电源,还会接住 Vibe Mode 的开机画面,让屏幕一直显示到 Muse 画出第一帧。代价是关掉 BSP 自带的 LVGL 层,图形库只留 Muse 那一份,免得两份打架。
Muse 自带一个桌面模拟器,给它加了一档 480 方屏的配置。待机、聆听、思考、配网、出错五个状态先在模拟器里看过,没有越界,再上板。
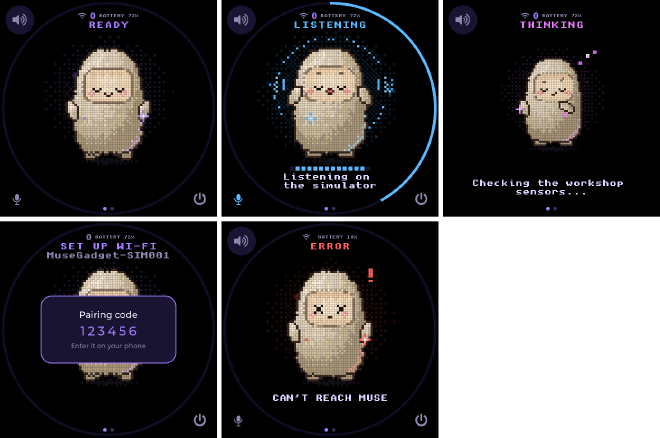
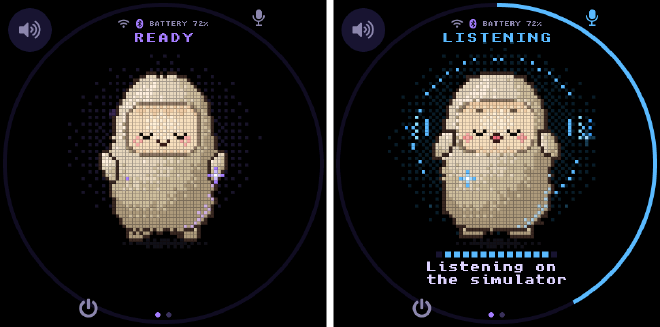
上板之后调了三处:
- 图标位置。 屏幕上麦克风和电源两个小图标,照板子的实际按键位置挪:麦克风挪到上边偏右正对 AI 键,电源挪到下边偏左正对 BOOT 键。
- 开机慢 8 秒。 电量计 BQ27220 第一次开机要写入配置,占了 8 秒。挪到后台任务,界面开机就出来,电量过几秒再显示。
- USB 掉线。 板子连上 Wi-Fi 之后,USB 上的 ESP-Iris 不再响应握手,固件装不进去。查到 ESP-Iris 同时开了 TCP 和 USB 两种通道,Wi-Fi 一通它就把 USB 丢了。关掉 TCP 通道,连续 4 分钟每 30 秒探一次,USB 都在。
顺手想到:ESP32 之外的 RK,以及无用之用#
8月底很火的 MicroDuck 是破圈了,399 美元,几天卖了一万多台,没有 Vibe Coding 的人都在说想买一个,想买一个干嘛呢?朋友说单纯做一个玩具也行。这个用的是瑞芯微的 RK3566,有比 ESP32 更强的本地能力,不少做机器人的都用了瑞芯微的芯片,说实话,我们自己在预研探索的产品用的也是 RK 系列的芯片,不过他们的芯片和 ESP32 系列不同的是做不小:我们现在已经遇到了想做小但散热解决不了的问题,甚至才用到它 CPU 的 20% 左右就烫得不行。再看看做 MicroDuck 的 Pollen Robotics,去年 4月被 Hugging Face 收了,今年 9月2日英伟达又宣布 129 亿美元收购 Hugging Face,LeRobot 和这些机器人背后站着的是英伟达,英伟达的模型和算力已经很牛逼,但虚拟世界再怎么模拟计算,再怎么解决 SIM2REAL 的 GAP,GAP 就是会存在,不如真实世界来的好。做这些产品,做不出来什么有用的东西,但能让团队/人了解开发具身智能这套工具链,就像我做这个没用的 Muse Gadget 一样,我知道他是怎么回事了,后面真想做有用的,或者一直跟他的技术进步,真能做出来有用的东西。
9月国内的安克也做了一件事情,搞首届黑客松(9月7日报名,10月中旬在深圳决赛),把自己公司成熟硬件产品的 SDK 开出来,邀请各位来一起构建应用。参赛的协议里面写的很清楚,参赛的设计、代码等都归安克所有。安克可以说是国内最近几年风头正劲的公司,AI NATIVE 推进也很靠前,人才济济的他为什么要做这样的事情呢?我相信他们也发现现在的 AI 除了在数字世界让 Human In The Loop 产生价值外,很难找到在消费品领域让用户买单的应用场景。他们类似 Plaud 的安克豆已经是目前 Agent 的极限状态,因为做个会议纪要,最后还是要我自己看一遍的。
三、让它有用一点#
中文字幕#
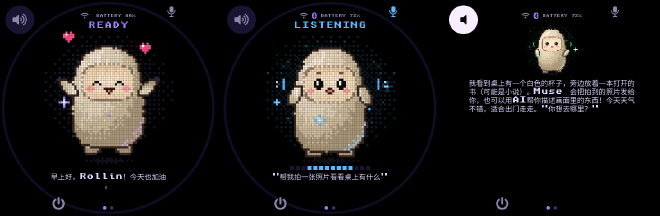
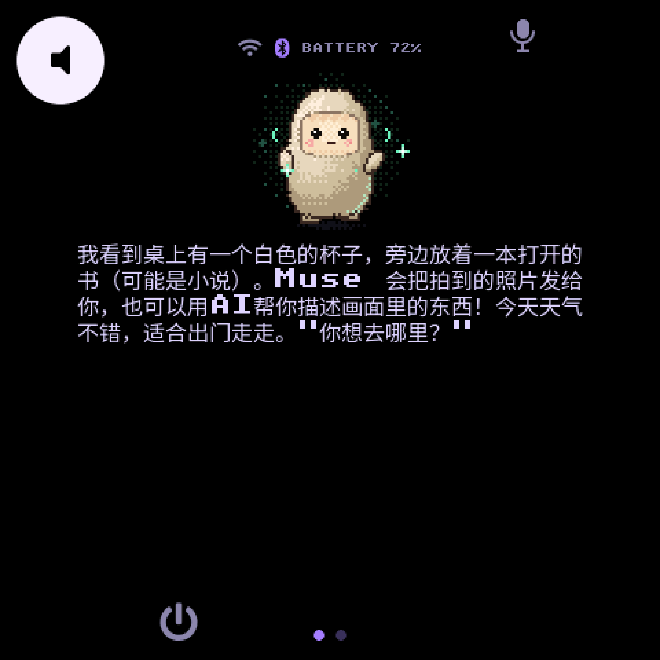
配对成功后第一次用中文提问,屏幕上一片空白。Muse 的字幕字体是 unscii,只有 ASCII。固件会把弯引号、破折号这些转成英文符号,汉字直接没了。
做法是给板子加一套 16 px 的中文字体:从思源黑体 CN 里取 GB2312 的 6763 个汉字加中文标点,共 6953 个字形,转成 LVGL 的二进制字体,884 KB。它编进固件,界面启动时载入 PSRAM,实测用了 0.57 秒。文件叫 cjk_16.bin,不叫思源的名字,因为 OFL 规定改过的字体不能沿用保留名。
Muse 这边加了一个「宽字体回退」:主字体没有的字去宽字体里找。两个细节要处理:
- 基线。 LVGL 把每个字形放在主字体的基线上,中文字体的基线不一样,要把宽字体的字形抬上去,不然汉字沉在行底。
- 换行。 中文没有空格,按字换行,闭合标点不落行首,开引号不落行尾。
还顺手抓到一个老 bug:字幕缓冲 400 字节,一个汉字占 3 字节,一页中文只能放半页,后半页被跳过。改成 800 字节,补了一条测试,旧代码跑这条会挂。后来又把 Markdown 从字幕里去掉了:行首的井号、列表号、引用号,行内的加粗、代码、删除线,链接只留文字。Muse 写回复很爱用这些符号,在 16 px 的字幕里只会碍事。
拍照#
Muse 的设备协议里,拍照是 Muse 主动叫设备拍:设备启动时向 Muse 声明自己支持 camera.capture,你问「看看我面前是什么」,Muse 判断需要看画面就调用它,设备拍一张 JPEG 传回去。官方 SDK 里只有 SenseCAP Watcher 实现了这个命令,而且写死了。改成任何板子只要注册了摄像头就会声明并响应,Watcher 的路径不动。
板子这边,摄像头子板插左槽。第一版按 BSP 文档里的 OV3640 写,让传感器直接出 JPEG。装上去一试,Muse 说拍了两次都失败:
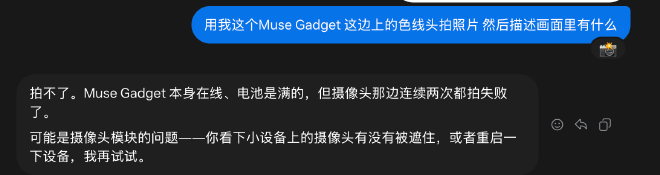
日志里是 format=JPEG is not supported。我手上这块子板的传感器是 SC101IOT,不是 OV3640,它没有 JPEG 模式。第二版改成取原始的 UYVY 画面,在板上用 esp_new_jpeg 编码,顺手逆时针转 90°,因为传感器在子板上是横着装的。拍完的照片在屏幕上显示 4 秒,能看到 Muse 收到的是什么。
两个额外的处理:
- 只在拍的时候上电。 每次拍照才认领子板、开传感器、丢掉前 10 帧等自动曝光稳定、取一帧、再全部关掉。平时摄像头不通电、不占内存。
- 引脚冲突。 摄像头的数据线和闪光灯占了芯片自带 USB Serial/JTAG 的两个引脚,所以那个口关掉了,Muse 的串口工具改走 UART。ESP-Iris 走的是另一个高速 USB 口,不受影响。
第二版实测:
| 项目 | 数值 |
|---|---|
| 画面 | 1280×720,转正后 720×1280 |
| JPEG 大小 | 93 KB |
| 编码耗时 | 326 ms |
| 方向 | 正的 |
语音#
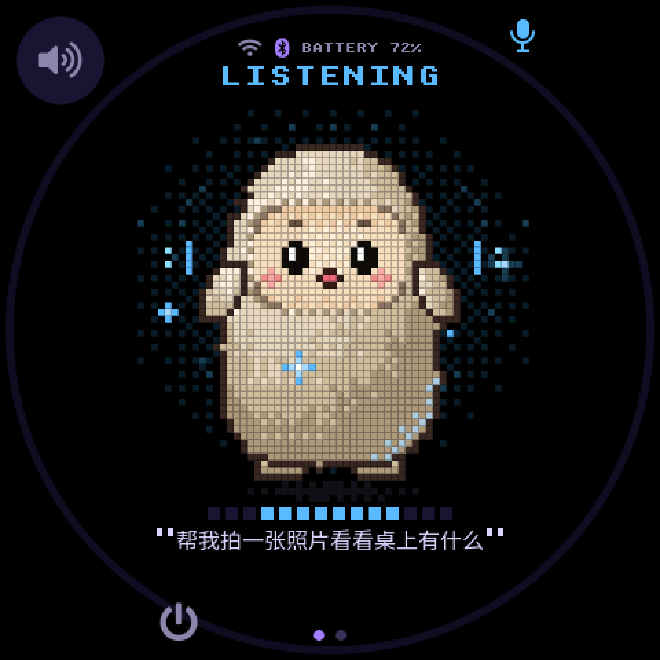
Muse 只回文字,不回语音。日志里那句「reply audio」只是按字幕节奏留出的静音,官方文档的说法是想要语音就自己接一个文字转语音服务。两条路:云端语音服务音质好,但每条回复多一次网络请求,还要经过 Mac 出网;板上离线合成音质偏机械、只会中文,但不联网、免费。先选了后者,乐鑫 esp-sr 的中文 TTS,小乐音色。第二天又补了前者的一个变体:不走云端,走我自己 Mac 上的 Qwen3-TTS。两条路现在都在固件里。
语音数据 2.9 MB,单独占一块分区:应用分区从 14 MB 缩到 11 MB,腾出 3 MB 放 voice_data。改了分区表就要用 system-update 重装一次,配对信息所在的 nvs 不在包里,装完配对还在。
esp-sr 只认汉字、数字和中文标点,Muse 的回复里有 Markdown、表情、链接和零星英文,念之前要先清理一遍:
- Markdown、表情和链接去掉
- 英文缩写按中文习惯念,AI 念「诶艾」,Muse 念「缪斯」;其他英文单词跳过,字幕里照常显示
- 「60%」念「百分之 60」,「25°C」念「25 摄氏度」
- 长句在逗号处分段,一段一段地合成,每段不超过 80 个字
- 整条回复没有中文就不念,只显示
喇叭开着时,字幕跟着语音走;喇叭关着时按阅读节奏翻页,和上游一样。
装上去第一次说话,板子复位了。从板上留存的 core dump 读到断言 s_task_stack_is_sane_when_cache_frozen。原因是我在 Muse 的对话任务里映射 voice_data 分区,映射会改 flash 的 MMU,期间 flash 缓存被冻结,而这个任务的栈在 PSRAM,缓存冻结时不允许访问 PSRAM 上的栈。改成开机时在主任务里映射,主任务的栈在片内 RAM。这条规则后来写进了接口的注释:栈在 PSRAM 的任务不能做 mmap、不能写 NVS、不能读写 flash。
修好之后的数据:
| 项目 | 数值 |
|---|---|
| 回复到达后开始出声 | 12 ms |
| 一条 11.1 秒的回复合成完 | 2.3 秒,约实时的 4.8 倍 |
| 语速 | esp-sr 的 4 档(0 到 5),3 档听着慢 |
英文也要念:接 Mac 上的 Qwen3-TTS#
小乐只会中文,Muse 的回复经常中英混着。我家里那台 Mac Studio 上本来就跑着一个 Qwen3-TTS 服务,OpenAI 风格的接口,中英都念。于是固件里加了第二条路:回复先交给 Mac 念,Mac 连不上时中文退回板上的小乐。
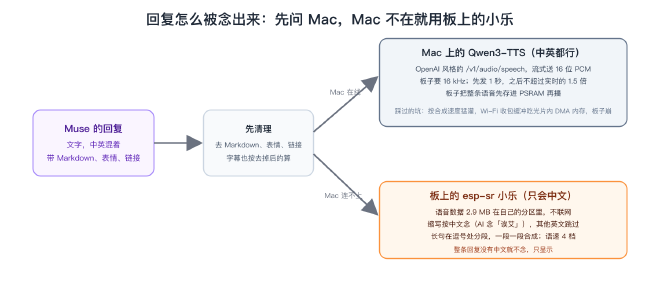
这条路第一版就把板子搞崩了。服务端按合成速度往板子灌 PCM,板子只开了 1 秒的下载缓冲,读不完的语音堆在网络协议栈里,占住 Wi-Fi 的接收缓冲,片内 DMA 内存被吃到 1 KB 以下。改成两头都收着:服务端先发 1 秒,之后不超过实时的 1.5 倍;板子把整条语音先存进 PSRAM 再播。试过把 Wi-Fi 的缓冲挪去 PSRAM,这颗芯片上进不去,反而多出一批常驻的发送缓冲,撤回了。
对话中随机复位:代码不要从 PSRAM 执行#
接着是一个更难的:对话中随机崩,空闲时也崩过一次。板上留下的 5 份 core dump 全是读内存出错,地址都是合法的 PSRAM 数据,而且全部落在 PSRAM 里只读区和可读写区的分界线之后 46 KB 以内。读了两个核的内存保护寄存器,都是对的。能稳定复现:同时跑一个内存锤子测试和边下载边播放,4 分钟左右崩一次。
查不到根因,但找到了绕法:关掉「代码从 PSRAM 执行」(CONFIG_SPIRAM_XIP_FROM_PSRAM),代码和常量改在 flash 里跑,PSRAM 只放数据,那条分界线就不存在了。同样的锤子测试跑 10 分钟零崩溃,两个核各锤了约 580 万轮;再跑 15 分钟,我同时用中英文对话,有语音、没崩。副作用是 ESP-Iris 那几项「放 PSRAM」的配置依赖这个功能,跟着失效,它的缓冲落回片内 RAM;好在开机后片内空闲 64.5 KB,和之前持平,PSRAM 反而多出约 4 MB。根因大概率在 ESP32-S31 加 ESP-IDF 主干这一层,8月中旬刚改过 S31 的 PSRAM 分区保护,这些证据可以拿去给乐鑫提 issue。
有人来了打个招呼#
这是另一个会话做的。右槽插 ESP-Mosaico 的交互模块,上面有一个 PIR 人体感应和 6 颗 WS2812 灯。想要的效果是我走到桌前,它亮灯、亮屏、打个招呼。
先用模拟器把画面画出来确认:开心动画、一声「叮」、按时段的一句字幕,显示 6 秒。问候语分早上、中午、下午、晚上、深夜五档,深夜是「夜深了,Rollin,早点休息」。板子原本不对时,Wi-Fi 连上后自己去 ntp.aliyun.com 对时,对上之前说「你好,Rollin!」。
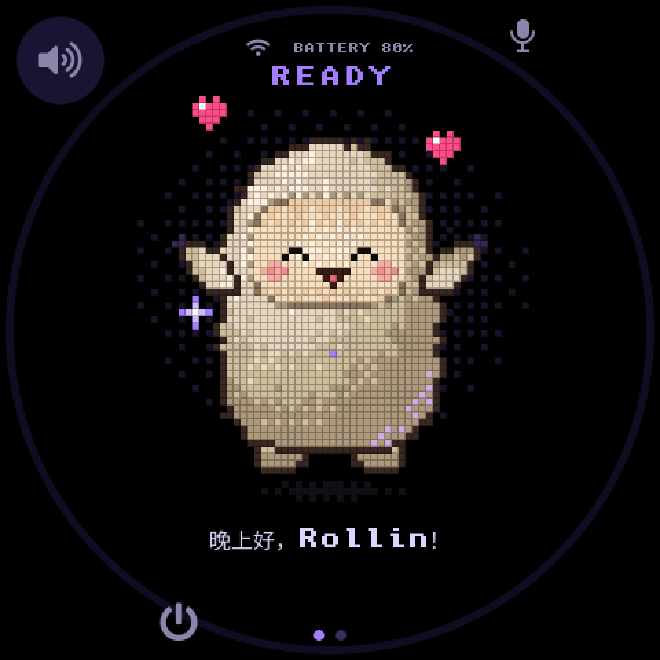
状态机只有三个时间常数,都写在源文件开头:
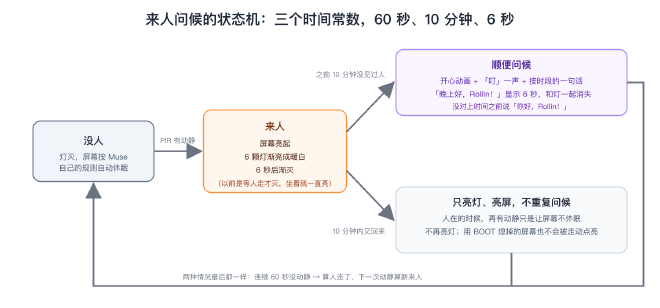
第一版上板,灯亮了不灭。日志显示来人和问候都在开机 90 秒时正常触发,之后我一直坐在板子前,人体感应持续报有动静,而原规则是连续 60 秒没动静才灭灯。改成灯和问候字幕一起亮、6 秒后一起灭,人在的时候再有动静只让屏幕不休眠,不再亮灯。灭灯没有日志可查,iris screenshot 在这个应用上也截不了图(Muse 自己驱动 LVGL,没接 Iris 的屏幕镜像),最后靠目测验收。
PIR 感应的是动作,不是存在。坐着一分钟不动再动一下,会被当成新来人,灯再亮 6 秒。
顺便算一笔内存账#
ESP32-S31 的片内 RAM 是紧的,Wi-Fi 和 TLS 都要从里面拿 DMA 内存。加上字体、语音、问候之后,Muse 就绪时的空闲片内内存从 74.7 KB 掉到 49.0 KB,DMA 内存最低到过 12 KB。两个会话各自把能挪的挪到 PSRAM:语音的文本缓冲和字幕页、问候任务的 4 KB 栈和状态。前提是查过它们的调用链不碰 flash。
| 版本 | 就绪时空闲片内 RAM | DMA 最低 |
|---|---|---|
| 只有摄像头 | 74.7 KB | 40 KB |
| 加字体、语音、问候 | 49.0 KB | 12 KB |
| 挪到 PSRAM 之后 | 65 到 68 KB | 28 KB |
| 关掉从 PSRAM 执行代码之后 | 64.5 KB | 未单独记 |
剩下的大头在 BSP 里:模块管理器以前拍照时才启动,现在开机就起,带两个各 4 KB 的片内栈,大小写死在子模块里。
顺手想到:感知这件事,语音比图像先落地#
语音转文字的信息现在是最容易被从真实世界收集上来的。
雷鸟 8月发的 iO 眼镜,全天候记录对话、只存转写的文字不存音频,雷鸟这个眼镜最牛逼的取舍就是把摄像头和扬声器都去掉了,34 克,有人戴这个眼镜如果不是我知道他是什么产品,我根本不会在意,但要是有个摄像头就会特别引人注意了,哪怕我说摄像头没工作也没人信的。我戴 Meta 的眼镜出门和在公司就遇到了这样的问题,总有人问我你摄像头没工作吧,语音信息反而没啥人在意。苹果在九月的发布会上也预告了 Apple Watch Series 12 的 Siri Recap:全天候听你的对话,只留摘要不存音频,年底 beta,世界上最牛逼的公司之一现在在消费品也只能做到这个地步了,全天候收集语音信息。不是说不能 24 小时收集图像信息,但那个代价太大了,不是消费品能做的,甚至现在智能眼镜的续航根本还做不到,其他类型的设备也还没出现,哪天消费品能出现一个 24 小时记录数据的,估计也只能是特定工作场景的具身智能机器人了,除了工厂,又有哪个场景需要机器人 24 小时工作呢?
四、反过来,让 Muse 使唤板子#
做到这里,板子是在「被动服务」:Muse 要看就拍,回复来了就念。我问 Muse「你能用 gadget 说话吗」,它答「没有扬声器播放的指令」。这句话点明了 Muse 和板子之间的关系:不是 MCP,是 Meta 自己的 Home Link 协议。板子连上时报一份命令清单,每条带描述和参数,Muse 看着清单决定什么时候调。上游的清单里只有五条:健康、发现、画一张网址图、放动画、拍照。
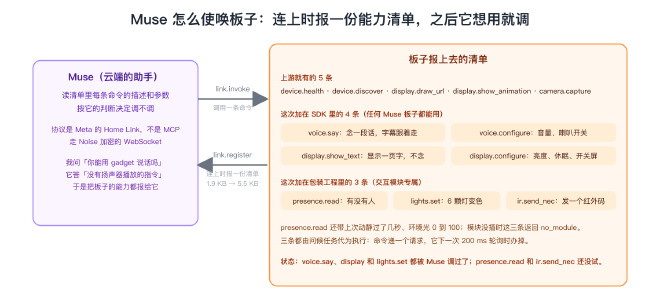
于是把板子的能力都报上去。SDK 里加了四条任何 Muse 板子都能用的:voice.say 念一段话、voice.configure 调音量、display.show_text 显示一页字、display.configure 调亮度和休眠。包装工程里加了三条交互模块专属的:presence.read 有没有人、lights.set 六颗灯变色、ir.send_nec 发一个红外码。注册的 JSON 从 1.9 KB 涨到 5.5 KB,Muse 服务端回了 200。
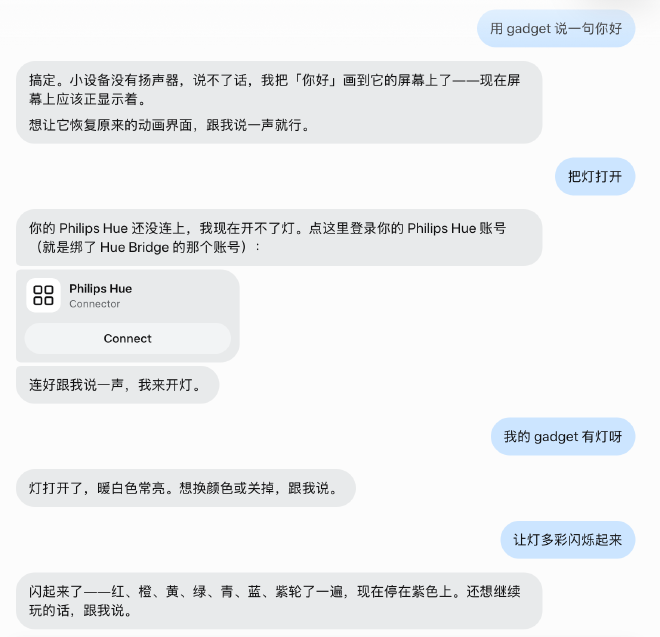
装上去试了一轮。第一次让它「用 gadget 说一句你好」,Muse 答「小设备没有扬声器,说不了话」,把「你好」画到了屏幕上,它记着的还是前一天清单里没有 voice.say 时的结论;新开一个对话再说一遍,板子就用 Mac 的声音说了「你好」,0.6 秒说完。「把灯打开」它先去找 Philips Hue,提醒它「我的 gadget 有灯呀」之后,六颗灯亮成暖白;再说「让灯多彩闪烁起来」,它把红橙黄绿青蓝紫轮了一遍停在紫色上,lights.set 被它连着调了好几次。
presence.read 和 ir.send_nec 还没让它调过。
顺手想到:Home Agent 这条赛道#
非常让我兴奋的是,Anthropic 9月预览了 Model Hardware Standard(MHS),打通硬件设备和 Agent 的沟通渠道,其实也不是什么高端的东西,大家都能想到,我兴奋是因为我的判断是对的,也正在推动团队做类似的事情,先把硬件做稳定,把硬件的能力通过 MCP 告诉 Agent,在软件层面做各种编排定制通过硬件来实现不同的感知-执行的工作。现在 Muse Gadget 也是类似的产品,你看 Meta 在 9月的 Connect 上发了个掌机 Muse Charm,那玩意儿不就是让大家先玩起来吗?现在这个 Muse Gadget 也不过是 Home Link 里面的一部分,Meta 明显是想从 Personal Agent 到 Home Agent,现在的智能家居也会被 Muse 这样的大脑管起来。
有传言 OpenAI 和 Jony Ive 的第一款硬件是个无屏幕、带摄像头和麦克风的桌面设备,年底前亮相、2027年上市,在这条路上前面已经有很多先驱了,在现在的 Agent 和模型能力下,用云端的应该是可以做到更好的家居体验了,不再是一个简单的智能语音音箱。国内的小米做了 Miloco(Xiaomi Local Copilot),6月开源了 2.0,用米家摄像头当眼睛、自家 MiMo 模型当大脑,为他们闭源的米家智能寻找更优的解决方案,现在最大的问题是每秒抽帧视频图像识别的成本和幻觉问题。
国内的安克和绿联两家公司 9月初都在 IFA 推出了「Home Agent」类似的产品,绿联的就叫 HomeAgent,入门款用 RK3588,顶配用英伟达的 Jetson Thor;安克的叫 MindBase。都描绘在本地解决因为摄像头带来的隐私问题,绿联在美国都已经注册下来 Home Agent 这个商标,看了他们的产品配置,确实是现在情况下能找到的优秀的配置,期待他们成品交付是什么样的效果。如果不自己做本地模型优化,我相信很难做到好的效果,但谁也说不准明天就出来个很牛逼的本地模型解决图像识别产生幻觉的问题。这个我也测试过,用面壁智能的本地模型 MiniCPM-V 识别出现了一个幻觉,把我白色的眼镜腿识别成了耳机,在我的工作流里,还有用 Fable 5.1 来做基线打分,可惜的是 Fable 5.1 也识别成了耳机,我对模型处理图像的能力精准度还持保守态度。
除了图像识别的问题,ASR 和 TTS 还是有很基础的问题。国内现在有两家头部的公司科大讯飞和思必驰,他们也有解决不了的问题,也可以说不是该他们解决的问题,如何区分多人,如何在嘈杂的环境里做到自然语言连续对话。我试过豆包打电话、ChatGPT 的实时语音、Gemini Live,他们都没办法和人一样听见了装作没听到这件事,所以不是感知-听得清这件事的问题,是背后“大脑”处理逻辑需要优化的问题,目前实时语音交互更适合单人在安静的环境,多人环境则适合非实时性要求不高的场景。单人实时语音交互这里也涉及到了意图识别,用户这句话到底是要我做事情,还是闲聊下去,目前来看 OpenAI 9月底发的 Dots(能打电话的常驻 Agent)做得很好,真的能很顺畅地跟人对话下去,意图识别做得好是一方面,另一方面是它背后有庞大的算力在支撑完成识别到的任务,不然一个任务需要 1 分钟才完成,再牛逼的对话衔接也补不上这个时间差的窟窿。
其实 Muse 用的 ASR 也很烂,当然本人普通话比较烂也是事实,不过同样的话 Muse 转译出来的完全没法看,甚至背后 LLM 都救不了语义识别,不如 Typeless 的体验。在好的设备采集到清晰可靠的音频后,优秀的 ASR 和 TTS 在实时语音交互过程中真的是尤为重要。前面说给板子加上 TTS 说话这条路,其实最简单的是接一个云端的 API,直接转,而且云端的效果肯定更好,对于做成熟消费品来说云端肯定是更好的选择。而我,家里有一个 Mac Studio,在5月买的,那时候买不到 256G,也没有 512G 的,二手市场炒到了天价,哪怕我只是一个 96G 的也能做很多本地的事情了,对于我来说尝试很多本地小模型够用了。我已经尝试在本地部署了我们正在开发的 Home Agent 项目,需要用到的图片/ASR/TTS 本地模型都没有问题,尝试整个链路完全是畅通无阻。
我们在研究 Home Agent 这条赛道的时候,团队其实最大的争议就是“主机太贵了,谁会买呀”,确实会买的人很少,便宜的能力又不够,而我这样想站在最前沿尝试的人会买。手里有一点算力,有 Token 真的感觉很爽,难以想象那些富豪有多爽,现在勉强可以想象了,在探索 AI 这条路上目前还没遇到大的阻碍,再大一点的模型我暂时也还玩不动,我主要是探索应用领域。
五、收工#
几个会话一起干活#
这个周末开了四个 Claude Code 会话,之后两天又开了几个。
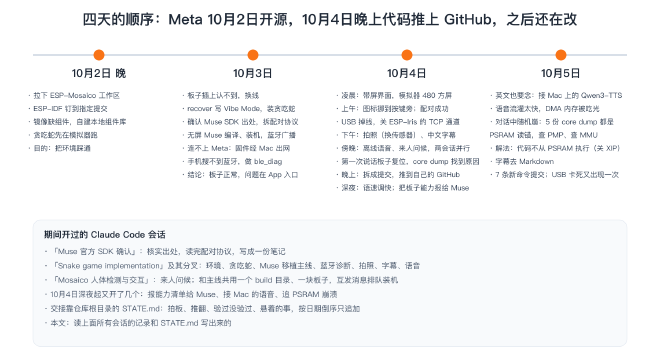
有意思的是最后一天下午,两个会话在同一块板子、同一个 build 目录上并行:一个做字幕、拍照、语音,一个做来人问候。它们之间互发消息排队:谁要编译先打招呼,装机前确认对方没在测,装完报一下 Boot ID 和内存数字。语音那边的崩溃修复和问候那边的灭灯修复,最后是合在一个固件里由一个会话装上去的。
交接靠仓库根目录的一个 STATE.md:拍板了什么、推翻了什么、验过和没验过的、悬着的事等谁。按日期倒序,只追加不改写。这篇文章就是读完所有会话记录和这个文件写出来的。
还有些问题#
- 报给 Muse 的七条命令里,
presence.read和ir.send_nec还没让它调过 - ESP-Iris 的 USB 链路运行几小时后会卡死,两次了,拔插线或者进 Vibe Mode 才恢复,原因没查到;板子里留存的日志在拔插之前就被覆盖了
- PSRAM 那个崩溃只是绕过去了,根因没找到
放大看:所有硬件都会被 AI 重做一遍#
去年最火的是具身智能,各个具身智能公司拿投资拿到手软,可是在去年大家都意识到了一个问题,没有让具身智能机器人快速成长起来的数据,他们需要的数据在这个世界现在没有,他们自己去建数据采集工厂,或者政府在投资建。在今年我们也看到了一些厂家进入家庭去采集数据的新闻,也看到了有人揭露现在政府投资的数据采集中心的问题,还看到了有具身机器人产品做开源,把硬件开出来,希望交给开发者去用,身边也有在做足够便宜给开发者用的具身智能机器人,希望能通过开发者将机器人带回家里,带到场景里面去做应用。蓝虫具身 9月发的「小白」是很有特点的,9800 元起,底盘、手臂、腰、头都是标准模块,快装接口组合,基本上做到了多场景适配,它这个状态充分说明一个问题,硬件的制造已经在瓶颈了,如果没有办法让具身智能机器人大规模商业化应用,硬件很难再有大的突破,急缺数据来训练机器人对这个世界的理解。大家都在想办法推出更便宜的硬件设备来让开发者用起来,可这个和车比起来,数量级还是太小了。
回到机器人本身。相信业内早已达成共识就是,双足人形机器人技术是最厉害的,但不是最实用的,后面在各个细分领域都有专属具身智能机器人在执行任务。扫地还是扫地机器人、割草还是割草机,以此类推。过去多少年来,我们已经发明太多非人形态的设备来提升效率了,未来我们这是要把这些设备都和 AI 结合起来,这也是为什么早就有人说“所有硬件都会被 AI 重做一遍”,这个重做一遍现在看来硬件层面的有,软件层面的也有。
人为什么要制造机器,是为了提升效率。其实同样一个任务交给人去做可能需要一个小时,但如果是交给 AI 做,10 分钟没做好就觉得这个 AI 不行,实时语音交互的 AI 设备和场景就会遇到这样子的问题。如何在 AI 硬件场景下解决普通用户对 AI 过高的期待,既需要工程化手段,也需要 AI 进一步普及,让普通用户也能理解 AI 的能力边界。
我不觉得会有任何一家厂商能做出来让所有用户满意的 AI 产品,AI 存在的意义就是实现用户的高度私人定制化,我现在做产品的思路不是去找那一个个会爆的应用场景,我是在找那些可能会“爆”的场景用户需要哪些共同的感知能力和执行能力,以及大脑的能力。硬件定制化肯定是晚于软件定制化的,我已经定制化开发了个人的 Personal Agent 碎碎念 Suisuinian,iOS App 和桌面端都有,现在我真的很想定制化开发一个硬件,它就是我 Personal Agent 的物理化身。
未来很长一段时间的 AI 产品,一定是软件硬件结合的,赋予用户自由创造的自由,硬件的能力一定会有冗余的,如果还在追求极致的成本管控,那根本不可能做的好 AI 硬件。只有冗余的硬件设计才能填补硬件开发物理周期和 AI 软件发展的时间差,同样一款硬件至少要覆盖半年以上的 AI 软件发展。今后不会再有公司做出来一款极致成本的 AI 硬件来解决用户的场景问题,一定是一些极客用户在某个场景下开发出了应用,帮助更多的人解决同样的问题,这个需求会被更细分,垂直的市场会更多,但他们用的可能都是同一款硬件。只有在量级超过一定数量之后才会去做 Cost Down 的操作,或者说 AI 能力发展要求硬件的能力更低之后成本会更低。
现在我就正在做一款集合超过 10 种感知能力于一体的设备,我把在家里能想到的感知能力都放进来了,还做了一个配套的 Agent,打算全开源出来给大家玩。希望能帮助你用 Claude/Codex 或者其他工具就能去实现你的想法,你完全可以不用操心硬件的事情。现在产品在收敛的状态,写这篇文章是希望如果你有类似的想法可以联系我,我们交流一下,一起共创,看看你还想加什么样的感知能力。